Simpatie.ro - matrimoniale
Forum Romania Inedit
Romania Inedit - Resursa ta de Fun
Nou pe simpatie:
sexy_andrea2006
Femeie
24 ani
Sibiu
cauta Barbat
27 - 53 ani
Forum Romania IneditReguliInregistrareLoginPozeNu sunteti logat. Lista Forumurilor Pe Tematici
Forum Romania Inedit / Totul despre cărți - About e-books /

AutoCorect versiune pentru Romania-Inedit

Pagini: 1 ... 29 30 31 32 33 34 35 ... 52 Moderat de Seven, Stelevadris, cuculean, naid, uncris
#776
utilitasetveritas
Pe lista neagra
Arata bine si al naibii de util


.be

Totodata faptul ca acele caractere aferente unei limbi straine au codul la vedere, permite inserarea lor in meniul de Combinatii Taste daca dorim sa grabim oleaca procesul.

Din punctul de vedere a unei persoane complet afoane in ale Character Map, indexarea acestor caractere e o mina de aur

In functie de limba si de caracterele folosite, este posibil sa apelam la o combinatie de meniu Diacritice si Combinatii Taste. Tastatura nu poate sustine un numar nelimitat de combinatii.

Nu s-a facut nici o incercare de a lucra efectiv pe un text cu aceasta optiune, dar banuiesc ca la corectura lui Nills ar fi prins tare bine

Totodata accesul la aceste caractere e simplificat enorm fata de vechea metoda cu Alt+12334 (tastat pe NumPad). Si permite accesul rapid la aceste caractere, si nu numai, chiar si acelor persoane ce nu au NumPad, asa cum sunt detinatorii de laptopuri.


#777
Seven
Moderator
Din: Ţara Perfectului Simplu
***
     Am făcut şi eu o probă cu noul executabil şi e foarte bună noua opţiune.
     Am o singură problemă. Apostroful romānesc nu e cel pe care īl cred eu că ar fi.
     Mă gāndeam că ar fi cel de la 146 / 2019, sub formă de 9 şi nu sub formă de 6, deci unul care seamănă cu virgula.
     Am o īntrebare de gāgă: unde se găsesc codurile pe care le folosiţi aici, că eu găsesc alte coduri īn ASCII şi Unicode pentru astfel de simboluri?

     Apropo, pentru amatorii de statistici, acest executabil este cel de-al 51-lea pe care-l am eu salvat de la īnceperea lucrului pe forum.
     Asta spune multe despre cāt a muncit Cosmin la programul ăsta.
     Sincere mulţumiri!


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#778
utilitasetveritas
Pe lista neagra
Poate ca ai codurile corecte dar ai un alt font selectat si arata diferit.
Daca te referi la codurile de la franceza si restul, le ai intr-o postarea de a mea cu 1-2 pagini in urma. E o lista lunga.
Daca e vorba de romana, trebuie sa te lamureasca Cosmin.
Oricum caracterele din acele liste sunt complet editabile.


51 de versiuni? 32 de pagini de topic?

E ceva. Mai devreme ma uitam pe primele pagini si la felul in care inceput totul

P.S.
Pana acum am auzit doar aplauze pe mail si o sugestie legata de alfabetul grecesc.

P.P.S.
Cosmin si Daniel

P.P.P.S
Imediat ce Cosmin o sa aiba chef.....
Una din chestiile care uneori ma calca pe nervi, e faptul ca atunci cand doresti sa folosesti mai multe fonturi intr-un document, nu prea stii care sunt acele fonturi ce accepta diacritice si trebuie sa faci n incercari.
S-ar putea face o impartire la ele sau o marcare?

Si uite si o chestie interesanta pentru impatimiti:

http://i18n.ro/Romanizator

http://i18n.ro/Fonturi_romanesti

P.P.P.P.S
Parca asta ar fi o lista, nu?
http://i18n.ro/Fonturi_romanesti/testare

Ma intereseaza doar acele fonturi ce sunt complet functionale ca diacritice.

P.P.P.P.P.S.
Intre timp am gasit o lista de fonturi si la secarica.
Asa ca mi-am rezolvat problema


Sistemul de operare Windows Vista are incluse atīt seria de fonturi de bază, cīt și o serie nouă de fonturi, optimizate pentru tehnologia ClearType.

Din punctul de vedere al limbii romāne, situația fonturilor de bază („core fonts”) este următoarea:

Arial (Normal, Bold, Italic, BoldItalic): font actualizat; compatibil cu limba romānă
Arial Black (N): font actualizat; compatibil cu limba romānă
Comic Sans MS (N, B): font actualizat; compatibil cu limba romānă
Courier New (N, B, I, BI): font actualizat; compatibil cu limba romānă
Georgia (N, B, I, BI): font actualizat; compatibil cu limba romānă
Impact (N): font actualizat; compatibil cu limba romānă
Lucida Console (N): font actualizat; compatibil cu limba romānă
Lucida Sans Unicode (N): font actualizat; compatibil cu limba romānă
Microsoft Sans Serif (N): compatibil cu limba romānă (acesta era oricum compatibil și īnainte, de pe vremea Windows XP)
Palatino Linotype (N, B, I, BI): compatibil cu limba romānă (acesta era oricum compatibil și īnainte, de pe vremea Windows XP)
Tahoma (N, B): compatibil cu limba romānă (acesta era oricum compatibil și īnainte, de pe vremea Windows XP)
Times New Roman (N, B, I, BI): font actualizat; compatibil cu limba romānă
Trebuchet MS (N, B, I, BI): font actualizat; compatibil cu limba romānă
Verdana (N, B, I, BI): font actualizat; compatibil cu limba romānă

Din punctul de vedere al limbii romāne, situația fonturilor noi, optimizate pentru tehnologia ClearType, este următoarea:

Calibri (N, B, I, BI): compatibil cu limba romānă
Cambria (N, B, I, BI): compatibil cu limba romānă
Candara (N, B, I, BI): compatibil cu limba romānă
Consolas (N, B, I, BI): compatibil cu limba romānă
Constantia (N, B, I, BI): compatibil cu limba romānă
Corbel (N, B, I, BI): compatibil cu limba romānă

Mai mult, la fonturile de bază, toate ţ/Ţ-urile cu sedilă (Unicode 0163/0162) au acum asociate glife tot cu sedilă, eliminānd astfel posibilele confuzii, introduse īn mod stupid acum mulți ani de către divizia de tipografie a companiei Adobe.


#779
ciuperca_cosmin
VETERAN
Din: Bacau
Problema era de la codul respectiv - era 8217 nu 8216, scuze. Word 2010 imi daduse la un moment dat 8216.
Am refacut exe-ul cu 8217 ca implicit.
Daca cineva a modificat deja setul la caractere de la romana acesta se reseteaza stergand ex_romana.dic din locatia "c:\Documents and Settings\Nume_utilizator\Application Data\AutoCorect Contemporan\Dictionare" pentru cei care au Windows XP, respectiv la "c:\Users\Nume_utilizator\AppData\Roaming\AutoCorect Contemporan\Dictionare\" pentru cei cu Windows Vista/7.

Codurile la caractere se gasesc in fereastra care apare cand se da click dreapta pe o "celula" si se alege Schimbare/Adaugare.

Daca aveti sugestii si de alte caractere folosite des le voi adauga.


#780
Seven
Moderator
Din: Ţara Perfectului Simplu
***
      Am reuşit să mă prind cu codurile astea.
      Eu vorbeam de coduri pe care le vedeam la insert symbol īn Word 2003 şi coduri 8217 şi 8216 apar la insert symbol īn Word 2010.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#781
ciuperca_cosmin
VETERAN
Din: Bacau
De fapt 2019 din Word si 8217 din AutoCorect sunt acelasi caracter. In Word e scris in baza 16, in AutoCorect e scris in baza 10.


#782
Seven
Moderator
Din: Ţara Perfectului Simplu
***
      Am īnţeles. De fapt asta voiam să īntreb, īn ce sistem de codare apare codul 8217.
      Acum am văzut că īn Word era numai Unicode 16, ci doar ASCII era și īn 10 și 16.
      Cred că ghilimelele ălea franțuzești « » ar fi bine să fie şi la limba romānă.

      Buun. Altă problemă.
      Mă chinui să fac un dicţionar pentru cifre romane. Am făcut ceva, deşi am corectat doar variante īn care I apare scris L mic, iar cifrele V, X, L ar fi corecte. Cel mai complicat este pentru numere de genul VIII, XIII, XVIII... pentru că la fiecare număr am luat īn calcul 7 variante erori.
      Merge bine īn varianta "VIII-lea" pentru că se poate seta Cuvānt īntreg [Ci] + Potrivire perfectă Pp].

      Dacă pun numai numere, ca de exemplu "VIII" setat Ci Pp, atunci nu mai face modificarea īn situaţia cānd găseşte "VIII-lea" sau "VIII-a"; dacă pun doar Pp fără Ci, atunci la sortare apare o bulibăşeală totală şi "VI" īntră peste "VII" şi "VIII"... aşa că nu ştiu cam cum s-ar putea rezolva cu cifrele astea romane.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#783
ciuperca_cosmin
VETERAN
Din: Bacau
Cateva imbunatatiri:
Am facut sa arate acum ambele coduri: in baza 16 (hex) si in baza 10 (dec). In acest fel cei care stiu codurile din Word le pot folosi si in AutoCorect.
Iar caracterele apar acum cu Bold (ca sa se vada mai bine).
Acu, in privinta ghilimelelor franceze: teoretic n-ar avea ce sa caute la "romana" deoarece sunt, prin insasi denumirea lor, "franceze"; totusi, cum sunt folosite in limba romana, da, e mai practic sa fie puse si la sectiunea "romana".
Le-am adaugat...

Altceva: ma gandeam sa implementez ca la unele caractere sa apara ca hint numele caracterului (de exemplu Em Dash). Dar problema e ca acesta e un nume in engleza si trebuie un nume romanesc. Dar multi utilizatori cunosc doar numele in engleza, respectiv traducerile in romana nu sunt prea "inspirate".
Deocamdata n-am ajuns la o "rezolvare"...

In privinta cifrelor romane. O rezolvare care o vad e sa adaugi toate variantele "VIII", "VIII-a" si "VIII-lea" cu Ci si Pp.
Da, stiu, e cel mai mult de munca in acest caz - dar pe moment nu vad sa existe alta solutie...

PS: poate sa le adaugi de la cel mai mare spre cel mai mic si apoi sa nu mai sortezi?
Adica, daca cuvantul era VII, il rezolva si apoi cand cauta ulterior VI nu-l mai gaseste...


#784
Seven
Moderator
Din: Ţara Perfectului Simplu
***
      Păi cam aşa am procedat. Am făcut cu Cc + Pp de la "II" la "LXXXIX" [2 - 89] atāt īn varianta VIII-lea, cāt şi VIII-a şi acestea pot rula fără nicio restricţie, pentru că nu pot avea efecte secundare.
      Pentru varianta cānd nu există decāt numărul simplu, cred că ar exista două variante:
         - una doar cu Pp de la VIII spre VI fără sortare, dar cu confirmare şi pus īn unul din dicţionarele cu variante;
         - a doua variantă ar fi aşa cum spui, tot de la 2 la 89, cu Ci şi Pp. Mă gāndisem la ceva cu cod de spaţiu... dar nu rezolvă problema atunci cānd este doar condiţia Pp.
      Probabil că māine plec din nou, aşa că-l voi definitiva la īnceputul săptămānii viitoare.

       Am uitat: am reactualizat Meniul OCR_Plus, aşa cum rulează el acum şi am īnceput să centralizez propuneri care nu au fost implementate, pentru ca după sărbători să vedem ce şi cum se mai poate implementa.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#785
ciuperca_cosmin
VETERAN
Din: Bacau
Am implementat fereastra de inserare simbol in fereastra de cautare respectiv la Inlocuire Multipla.

http://www.mediafire.com/?y95ljma17fxnj7l


#786
utilitasetveritas
Pe lista neagra
Il iau imediat :*
Nu ar fi mai usor sa poti sa lucrezi si cu Cautare/Inlocuire si cu fereastra cu caractere speciale ordonate pe limbi in acelasi timp?


#787
ciuperca_cosmin
VETERAN
Din: Bacau
Da, probabil ar fi ceva mai usor pentru cei care folosesc caractere din acea fereastra.
Problema e ca daca pui doar una din ferestre te trezesti ca sunt situatii in care ai nevoie de cealalta.
Iar daca le pui pe amandoua e redundant pe jumatate deoarece au in comun jumatate.
Greu de ales
As vrea sa stiu si parerea altora...

Seven, zilele acestea ma gandesc sa implementez OCR Plus si in AutoCorect Clasic. La dictionarele imd folosite e suficient sa faci o conversie text contemporan in clasic sau trebuie totusi si alte "adaptari" ca sa functioneze eficient si pe Clasic?


#788
Seven
Moderator
Din: Ţara Perfectului Simplu
***
     OCR Plus īn Clasic?... Īmi pare rău, pur şi simplu, nu ştiu ce să răspund.
     Nu ştiu dacă dicţionarele OCR_DIC ar funcţiona eficient la simpla īnlocuirea lui ā/Ā cu ī/Ī īn dicţionare...
     Am lucrat tot timpul doar īn limbaj contemporan, astfel că toate dicţionarele mai vechi sau mai noi au fost gāndite pentru limbaj contemporan, plecānd de la OCR-ul unei cărţi tipărite īn limbaj contemporan sau de la OCR convertit īn prealabil.
     Sigur este faptul că multe īnregistrări nu se justifică īn limbaj clasic pentru că ele pleacă de la confuzia īntre ă/Ă şi ā/Ā...

     Trebuie să fac o verificare mai atentă a fiecărui dicţionar īn parte, dar īn următoarele zile nu ştiu dacă am suficient timp la dispoziţie, pentru că realizarea dicţionarelor īnlocuiri secvenţe de cuvinte īmi ia foarte mult timp.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#789
ciuperca_cosmin
VETERAN
Din: Bacau
Am inteles, nu-i nicio problema, cand ai timp, multumesc.


#790
Seven
Moderator
Din: Ţara Perfectului Simplu
***
      Apropo, de dicţionarele de īnlocuiri secvenţe:
      Utilitarul făcut de tine īmi este de foarte mare ajutor şi-ţi mulţumesc foarte mult pentru acest executabil; altfel aş fi cotrobăit mult şi bine prin dex.

      Căutānd prin dicţionarele autocorect m-am īntālnit cu o serie de turcisme care-mi dau dau un pic de furcă... ele sunt scrise cu terminaţia "RLC", "RLCURI" timp īn care eu credeam că ar trebui scrise "RLĀC", "RLĀCURI"...
       Exemplu: samsarlc, pazarlcuri, şmecherlcuri, musafirlcuri... eu parcă aş merge pe: samsarlāc, pazarlācuri, şmecherlācuri, musafirlācuri
       Am făcut o mică listă cu astfel turcisme, dar şi alte cuvinte despre care am dubii.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#791
ciuperca_cosmin
VETERAN
Din: Bacau
Da cred ca ar merge schimbate, cand e gata lista sa ne-o dai te rog sa ne uitam si noi. Multumesc.


#792
Seven
Moderator
Din: Ţara Perfectului Simplu
***
      Īn urmă cu cāteva minute, am urcat ultimele variante de dicţionare care lucrează cu OCR_Plus şi chiar ceva īn plus.
      Dicţionarele se află īn cunoscutul folder, ce se poate accesa şi din semnătura subsemnatului.
      Adresa folder:  http://www.mediafire.com/?55d9z4rn383zn
      Nume fişiere:
                  [20.12.2011] Dic Cifre romane.rar
                  [20.12.2011] Dic Secvenţe.rar
                  [20.12.2011] OCR_DIC.rar

                 
      Cāteva amănunte despre fiecare arhivă īn parte:

                  [20.12.2011] Dic Cifre romane.rar – cuprinde cifre romane īn forma «....-lea» şi «....-a» de la 2 la 89... am considerat că nu e nevoie de mai mult, dar pot merge pānă la 99.
      Am făcut corecturi ale "cifrei" «I» scrise la litera L mic, ori H sau U acolo unde sunt īn grup de cel puţin două «II»: Am să dau un exemplu, dar nu ştiu dacă se poate observa foarte bine: erori ce pot apărea īn locul lui VIII-lea:  VlII-lea, VIlI-lea, VIIl-lea, VllI-lea, VIll-lea, VlIl-lea, Vlll-lea, VHI-lea, VHl-lea, VIH-lea, VlH-lea, VUI-lea, VUl-lea, VIU-lea, VlU-lea.
      Nu am făcut īncă cele două combinaţii cu H şi U la numerele care au īn componenţa lor doar doi de «I»;
      Este īn curs de editare dicţionarul cu numere nearticulate. Cred că acestea vor avea condiţia "cu confirmare" pānă la numărul 18, spre a evita producerea de modificări nedorite.
      Deocamdată nu ştiu īn ce poziţie a meniului OCR_Plus ar trebui să ruleze... dacp, eventual ar trebui inserată o nouă opţiune sau nu... īnclin să fie o opţiune secundară spre finalul meniului, eventual la pachetul 12.

                  [20.12.2011] Dic Secvenţe.rar – cuprinde dicţionare īn care modificările nu se fac asupra cuvintelor, ci asupra secvenţelor de cuvānt.
      Īn dicţionarele AC sunt trei tipuri de secvenţe de cuvinte:
           – secvenţe de cāteva litere la īnceput de cuvānt: acestea sunt precedate īn dicţionare de codul ^w care īnseamnă spaţiu; ex: ^wrc se modifică īn ^wre, adică grupul «rc» la īnceput de cuvānt se transformă īn «re», deoarece niciun cuvānt īn limba romānă nu īncepe cu grupul «RC» – astfel de secvenţe au fost adăugate la unele dintre vechile dicţionare L1-L3 şi S1-S4.
           – secvenţe la sfārşit de cuvānt: acestea sunt urmate īn dicţionare de codul ^w = spaţiu; ex: ndu-tc^w se modifică īn ndu-te^w;  – astfel de secvenţe au fost adăugate la unele dintre dicţionare L1-L3 şi S1-S4.
           – secvenţe mediane, aflate la īnteriorul cuvāntului. De astfel de secvenţe se ocupă dicţionarele din arhiva Dic Secvenţe.rar.
      Aceste dicţionare rezolvă următoarele 3 situaţii: litera L mic īntre două consoane se modifică īn I mic; litera C mic īntre două consoane se modifică īn E mic; grupul de litere RN minuscule īnaintea unei consoane se transformă īn litera M mic.
      Īn situaţiile īn care la o anumită secvenţă au rezultat un număr mare de cuvinte care există īn formula iniţială "consoană-L-consoană" sau "consoană-C-consoană", această sevenţă nu a fost trecută īn dicţionare; īn cazurile īn care existau un număr mic de cuvinte īn formula iniţială, secvenţa a fost trecută īn dicţionar, iar la sfārşitul dicţionarului, au fost făcute īnregistrările pentru corectarea respectivelor cuvinte.

      Deocamdată dicţionarele nu sunt integrate īn meniu; Dicţionarul "Secv_RNM va fi adăugat la vechiul dicţionar "DGrn.imd", iar celelalte... ar putea fi inserate īn "S3.dic" ori, eventual reorganizate īn două dicţionare separate: unul pentru secvenţa "consoană-L-consoană" şi altul pentru secvenţa "consoană-C-consoană"...

                  [20.12.2011] OCR_DIC.rar – dicţionarele au fost īmbunătăţite cu īnregistrări noi, īn special secvenţe de cuvinte iniţiale şi finale, dar şi un număr respectabil de secvenţe mediane, precum şi alte īnregistrări.


_______________________________________

     Oameni şi popoare īşi cată libertatea; după ce-o obţin, īşi caută stăpān.


     | TORENTE | Tăunul | ROCAMBOLE+ | FLORIS | VRACIU | Victor HUGO | J.F. COOPER | PAPILLON | POLDARK |
     | Dictionare Lba RO | | Gramatica RO | D. Stănoiu | Zaharia STANCU | H.Y. STAHL | V.CORBUL & E.BURADA |
     | Ultimul regat | Millennium | Shantaram | Pearl BUCK | Anchee MIN | Amy TAN | C. LÄCKBERG | Ph.GREGORY |
     | Extraterestrii şi Intraterestrii | RUFOR | Demonul Roşu | Vraja milioanelor | Cărţi audio |


#793
utilitasetveritas
Pe lista neagra
Hmmmm... Cosmin.... am un text oarecare, rulez functia de conversie diacritice cu diacritice virgula, apoi fac cateva inlocuiri manuale de diacritice. Dar acestea apar cu sedila.

Cum facem sa ii spunem AC-ului sa lucreze doar cu diacritice cu virgula sau doar cu sedila intr-un text?
Am folosit doar tastatura AC-ului.

Si tot acum am observat ca diacrticele cu virgula nu apar la fereastra de caractere speciale impartite pe limbi.


#794
ciuperca_cosmin
VETERAN
Din: Bacau
Pentru ca functiile din AutoCorect sa puna automat diacritice cu virgula te duci in meniul Instrumente >> Configurare >> Diacritice si dai o bifa la "Foloseste diacritice cu virgula". Aici nu e bifat implicit deoarece nu toate calculatoarele au fonturi care le pot afisa.
Pina inainte de a avea fereastra cu caractere aranjate pe limbi, cand dadeai click pe ş ţ in acea tabela de diacritice (care avea doar cate un buton de fiecare), iti dadea automat cu sedila sau cu virgula depinzand daca era bifat sau nu in locatia respectiva.
Acu, deoarece fereastra noua de caractere e prea specializata, nu e corect sa le transforme automat. Corect ar fi sa existe la tab-ul "Romānă" ambele categorii de diacritice astfel incat utilizatorul sa aleaga pe ce sa dea clic. Dar problema e ca pe unele calculatoare cele cu virgula nu vor fi afisate corect (lipsesc acele fonturi) si de aceea nu le putem adauga implicit la lista de caractere. Plus ca oricum nu e asa de usor sa faci rapid deosebire intre cele 2 tipuri de diacritice - probabil unii vor da clic din greseala pe celalalt tip.
Asta e problema cu noua fereastra de caractere... 


#795
xtybyx
MEMBRU VIP
Multumesc frumos la toti cei care au cotribuit la acest program, care pentru mine este de mare ajutor. Va doresc sarbatori fericite si sa se implineasca toate dorintele voastre.


#796
utilitasetveritas
Pe lista neagra
Un moment, Cosmin.

Diacriticele sunt inserate automat de AC atunci cand:
- se ruleaza optiunea de conversie de text (functia "Conversie text clasic in text contemporan" sau viceversa).
- atunci cand de se face adaugarea automata de diacritice in text (functia Diacritice).
- sau atunci cand sunt adaugate manual de utilizator.

Am gasit intr-adevar optiunea din Configurare > Diacritice. De acolo se seteaza tipul de diacritice folosit.


Daca zici ca nu vrei sa fie confuzii in tabul de Romana din fereastra de Caractere Speciale, eu recomand sa faci 2 taburi de romana, Romana cu Sedile, Romana cu Virgula.

Problema pe care o aduc in discutie suna cam asa:

- se ruleaza conversia diacriticelor pe un text (se transforma in virgula) sau se deschide un text cu diacritice cu virgula.

- se lucreaza pe acel text cu functia Diacritice (asta inseamna ca in textul cu diacritice cu virgula, vor fi inserare diacritice cu sedila), apoi se ruleaza Ortografia (banuiesc ca acele cuvinte inserate vor fi tot cu sedila), apoi se fac diverse corectari din tastatura, iarasi vor fi cu sedila. In final vom avea un text cu diacritice mixte.

Nu e neaparat o problema majora, e o chestie de finisare finala. Presupun ca la urma se poate rula din nou conversia diacriticelor, fie in virgula, fie in sedila. Iar textul o sa capete diacriticele corecte si uniforme.

Dar, dupa cum ai zis si tu, nu toata lumea face deosebirea intre cele 2 tipuri de diacritice si exista riscul ca acel text sa raman cu diacritice mixte.

Din punctul meu de vedere, folosind ceea ce stiu deja si informatia oferita mai sus de tine, eu consider problema rezolvata. Necesita atentia utilizatorului totusi.

Dar ar fi bine daca am putea sa fim avertizati atunci cand textul contine deja diacritice mixte, sau AC-ul "detecteaza" faptul ca setarile sale implicite (legate de diacritice) vor duce la o asemenea situatie.

P.S.
Din moment ce AC-ul se ocupa in principal de limba romana, nu poti sa ii pui in installer ambele tipuri de fonturi? Nu ar mai fi probleme cu vizualizarea in felul asta.


#797
ciuperca_cosmin
VETERAN
Din: Bacau

utilitasetveritas a scris:

Daca zici ca nu vrei sa fie confuzii in tabul de Romana din fereastra de Caractere Speciale, eu recomand sa faci 2 taburi de romana, Romana cu Sedile, Romana cu Virgula.


In primul rand sa fac un tab in plus pentru doar 4 caractere e redundant. In al doilea rand asta tot nu rezolva problema mentionata anterior de mine: daca utilizatorul nu are fonturile respective instalate pe calculator nu se vor vedea bine in fereastra de caractere sortate pe limbi.


utilitasetveritas a scris:

Problema pe care o aduc in discutie suna cam asa:

- se ruleaza conversia diacriticelor pe un text (se transforma in virgula) sau se deschide un text cu diacritice cu virgula.

- se lucreaza pe acel text cu functia Diacritice (asta inseamna ca in textul cu diacritice cu virgula, vor fi inserare diacritice cu sedila), apoi se ruleaza Ortografia (banuiesc ca acele cuvinte inserate vor fi tot cu sedila), apoi se fac diverse corectari din tastatura, iarasi vor fi cu sedila. In final vom avea un text cu diacritice mixte.

Nu e neaparat o problema majora, e o chestie de finisare finala. Presupun ca la urma se poate rula din nou conversia diacriticelor, fie in virgula, fie in sedila. Iar textul o sa capete diacriticele corecte si uniforme.

Dar, dupa cum ai zis si tu, nu toata lumea face deosebirea intre cele 2 tipuri de diacritice si exista riscul ca acel text sa raman cu diacritice mixte.

Din punctul meu de vedere, folosind ceea ce stiu deja si informatia oferita mai sus de tine, eu consider problema rezolvata. Necesita atentia utilizatorului totusi.

Dar ar fi bine daca am putea sa fim avertizati atunci cand textul contine deja diacritice mixte, sau AC-ul "detecteaza" faptul ca setarile sale implicite (legate de diacritice) vor duce la o asemenea situatie.


Problema asta s-a mai discutat si a ramas in aer. Pe jumatate e obligatia utilizatorului de a se asigura ca lucreaza cu diacriticele care le vrea el pentru text. AutoCorect ii ofera mijloacele de a seta tipul ce va fi utilizat de functia Diacritice respectiv o functie de conversie, daca nu le utilizeaza e alegerea lui. Pe de alta parte aceste mesaje de tipuri de diacritice ar fi agasante pentru utilizatorii carora nu le pasa despre acest lucru. Cum sa impacam pe toti, asta-i intrebarea.


utilitasetveritas a scris:

P.S.
Din moment ce AC-ul se ocupa in principal de limba romana, nu poti sa ii pui in installer ambele tipuri de fonturi? Nu ar mai fi probleme cu vizualizarea in felul asta.


Din pacate nu se poate deoarece acestea sunt proprietate Microsoft. Mai devreme sau mai tarziu ne vom pomeni cu mesaje oficiale de la Microsoft care ne vor cere sa le scoatem. Au patit-o altii.
Acu putin imi pasa de Microsoft dar totusi as vrea ca AutoCorect sa ramana legal...


#798
utilitasetveritas
Pe lista neagra
Daca nu putem impaca si capra si varza... si lupul atunci te inteleg.
Ramane in aer si cu alternativele discutate mai sus drept rezolvare.

P.S.


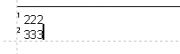
Notele de final numai asa sunt notate? Cu cifre romane?
Si daca da, nu se poate folosi XI, XII, XII, etc?


#799
ciuperca_cosmin
VETERAN
Din: Bacau
AutoCorect pune de obicei cifre obisnuite:


#800
utilitasetveritas
Pe lista neagra
La mine, notele de final, apar ca in imagine.
Deci, atentie, note de final, nu note de subsol.
Vezi clipul de mai jos. E HD.


Pagini: 1 ... 29 30 31 32 33 34 35 ... 52  
Mergi la